 Tech Review
Введение
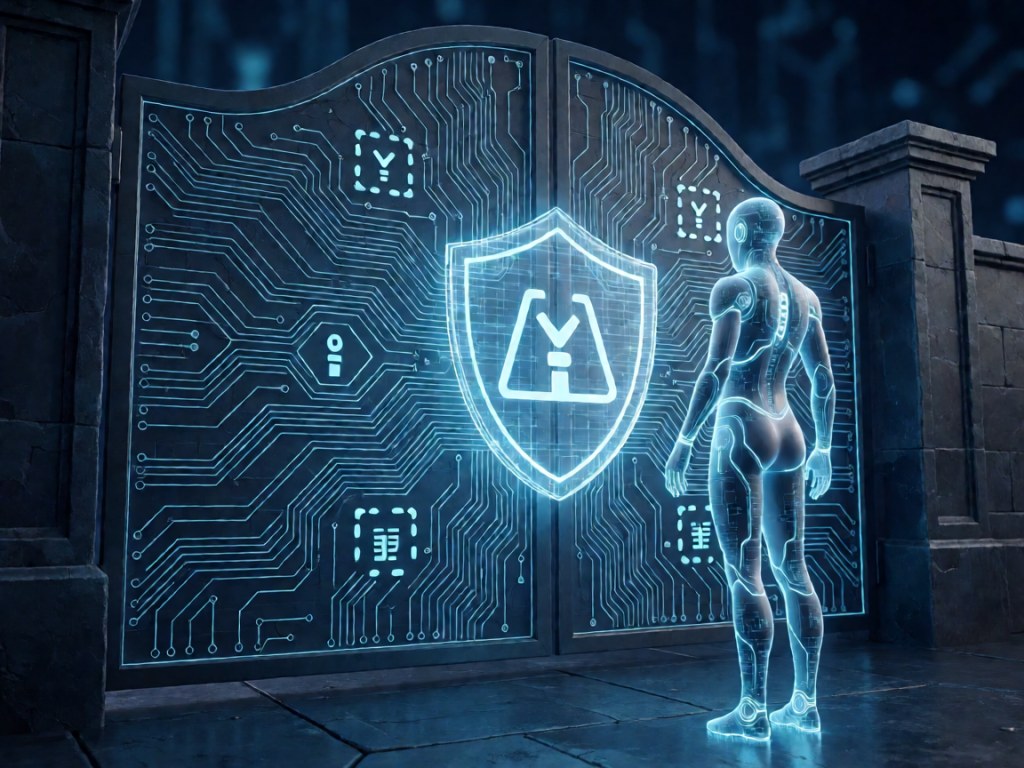
Пока индустрия спорит о том, насколько умны большие языковые модели, ИИ-агенты — автономные системы, способные самостоятельно выполнять задачи в браузере — упираются в куда более приземлённую стену. Она состоит из капч, проверок на «человечность», блокировок ботов и юридических запретов на автоматизированный доступ. Иными словами, технически агент уже готов забронировать билет, сравнить цены или заполнить форму, но сайт просто не откроет ему дверь.
Детали
Проблема лежит на пересечении трёх плоскостей: технической, правовой и экономической.
Техническая сторона. Большинство современных сайтов защищены системами вроде Cloudflare, Akamai, DataDome и reCAPTCHA. Они анализируют поведение посетителя: движения курсора, скорость набора, отпечаток браузера, IP-адрес. Агент, работающий через headless-браузер или API, легко вычисляется по этим признакам. Даже если он маскируется под обычный Chrome, характерные паттерны — например, слишком быстрые и «идеальные» клики — выдают его.
Правовая сторона. Многие сервисы прямо запрещают автоматизированный доступ в пользовательском соглашении. В США прецедентное право вокруг «парсинга» и обхода технических барьеров остаётся неоднозначным: одни суды трактуют обход капчи как нарушение закона о компьютерном мошенничестве, другие — как допустимую конкуренцию. Для разработчиков агентов это означает юридическую серую зону.
Экономическая сторона. Сайты защищаются не из вредности. Реклама, подписки и аналитика строятся на живых пользователях. Если агенты начнут массово бронировать товары, оставлять заявки или генерировать трафик, бизнес-модель площадок пошатнётся. Отсюда и жёсткость фильтров.
Анализ
Складывается парадокс. Компании вроде OpenAI, Google и Anthropic продвигают агентов как следующий большой шаг после чат-ботов: вместо ответа на вопрос агент сам совершает действие. Но интернет исторически проектировался для людей, а не для автономных программ. Отсюда — попытки создать «агентский» веб: специальные протоколы, машинно-читаемые интерфейсы, доверенные идентификаторы ботов.
Часть площадок уже экспериментирует с «паспортами» для агентов — криптографически подписанными токенами, которые подтверждают, что запрос исходит от легитимного ИИ-ассистента, а не от скрейпера. Другие, наоборот, усиливают защиту, опасаясь, что открытая дверь обрушит их инфраструктуру.
Ключевой конфликт — в отсутствии общей договорённости. Пока нет единого стандарта, каждый сайт решает сам: пускать агентов, блокировать или взимать плату за доступ. Это фрагментирует среду и тормозит развитие полезных сценариев — от автоматизации покупок до доступности сервисов для людей с ограничениями.
Мнение
На мой взгляд, победит модель «управляемого доступа», а не тотальной блокировки. Сайтам выгодно, чтобы агенты работали — но на их условиях: с идентификацией, лимитами и, возможно, платой. Полный запрет бессмысленен: как только агент станет по-настоящему полезен, пользователи начнут давить на сервисы, требуя совместимости.
Другое дело, что инфраструктура к этому не готова. Нужны стандарты аутентификации агентов, прозрачные правила и технические механизмы вроде rate-limiting на уровне протокола. Пока этого нет, нас ждут годы «кошки-мышки»: разработчики обходят защиты, сайты придумывают новые.
Итог
Следующая большая преграда для ИИ-агентов — не интеллект, а доступ. Модели уже умеют планировать и действовать; проблема в том, что интернет закрыт для них капчами, соглашениями и бизнес-логикой. Решение потребует не только технологий, но и договорённостей между платформами, разработчиками и регуляторами. До тех пор агенты останутся умными, но запертыми снаружи.
FAQ
Почему сайты блокируют ИИ-агентов, если те полезны пользователям?
Потому что массовый автоматизированный доступ угрожает рекламной модели, нагружает инфраструктуру и открывает путь для злоупотреблений — от скальпинга билетов до спама.
Существуют ли стандарты для «легальных» агентов?
Единого стандарта пока нет. Обсуждаются криптографические идентификаторы и протоколы доверенного доступа, но массового внедрения ещё не произошло.
Может ли агент обойти капчу законно?
Это зависит от юрисдикции и условий конкретного сервиса. В большинстве случаев обход технических защит нарушает пользовательское соглашение и может иметь правовые последствия.